
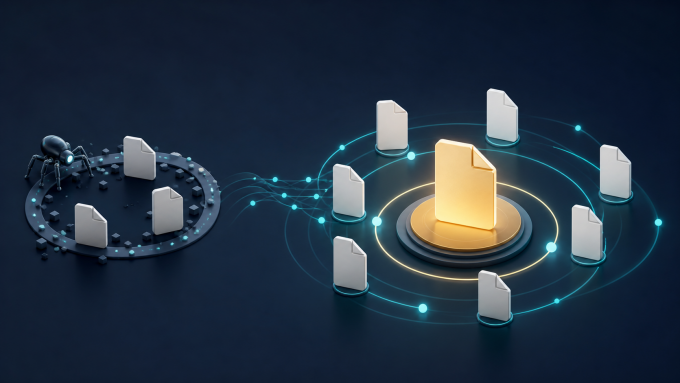
Дубли страниц в Google: почему повтор не всегда означает поисковый штраф

В отчете найдены параметры с одинаковым текстом, и команда сразу ожидает penalty, хотя обычно поисковая система сначала группирует похожие документы и выбирает один representative URL.
Отделите duplication от abuse
Технические копии из фильтров, протоколов или tracking parameters распространены и не создают автоматического spam action. Намеренное массовое копирование ради ranking имеет другую цель.
Укажите предпочтение
Redirect, rel canonical, sitemap и последовательные internal links помогают выбрать главную версию, а все сигналы должны указывать на один crawlable URL.
Сократите лишний обход
Большое число дублей размывает reporting и тратит ресурсы crawler на слабые комбинации. Исправьте генератор параметров и навигацию у источника.
Сгруппируйте дубли по причине, выберите canonical behavior для каждого шаблона и проверяйте решение через URL Inspection, а не страх штрафа.
Выбор основной версии объясняет статья про rel canonical. Источник: Google Search Central.
Comments are closed.